ブラックリスト(コンピューティング):概念、実装、トレードオフ
コンピューティングにおけるブラックリストは、アクセスまたは実行を拒否する対象の一覧です。本記事では、仕組み、一般的な実装、歴史、用途、限界、ホワイトリストとの違いを解説します。
概要:コンピューティングにおけるブラックリストとは、IPアドレス、ドメイン名、ファイル、アプリケーション、電子メール送信者、URLなどの特定の対象に対し、リソースへのアクセスまたは操作の実行を許可しないアクセス制御の仕組みである。ブラックリストは、対象を維持管理された一覧と照合して機能し、一致が見つかった場合は要求を遮断またはフラグ付けする。システムでは、より広範なセキュリティまたはポリシーの枠組みを構成する一要素としてブラックリストを参照することが多い。一般的なアクセス制御の概念については、関連ドキュメントを参照。
画像ギャラリー
2 画像
特性と一般的な実装
ブラックリストは、静的ファイル、データベーステーブル、メモリー上の集合、クラウドベースのレピュテーションフィードとして実装できる。一般的な対象には、次のものがある。
- IPアドレスおよびアドレス範囲(ファイアウォール、侵入防止)
- ドメイン名およびURL(ウェブプロキシ、コンテンツフィルター)
- 電子メール送信者およびメッセージ署名(スパム対策)
- 実行可能ファイルのハッシュまたはアプリケーション識別子(エンドポイント保護)
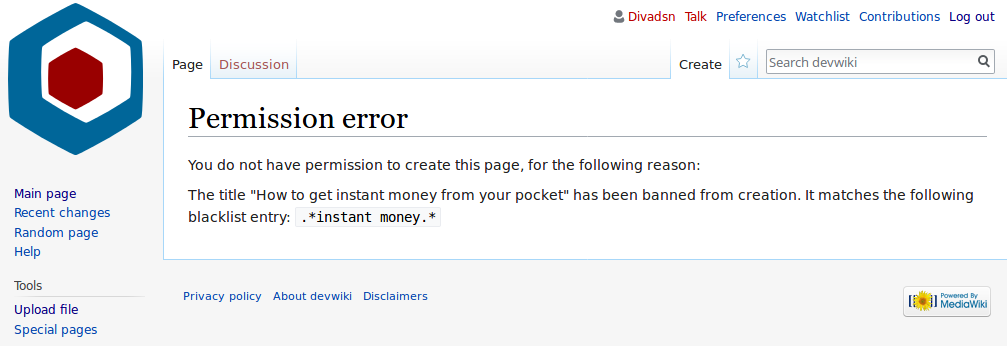
照合には、完全一致する識別子、パターンマッチング、正規表現、確率的なレピュテーションスコアを利用できる。調査と是正を支援するため、ブラックリストはログ記録、アラート、上書き制御と組み合わせて使用されることが多い。
歴史と進化
ブラックリストの概念は近代的なネットワークより前から存在し、システムに単純なルールベースの遮断が必要となるにつれてコンピューティングにも適用された。時代とともに、ブラックリストは手作業で作成・管理される一覧から、自動化されたフィードや機械学習支援型のレピュテーションシステムへと進化した。管理者は、エントリーを最新の状態に保つため、セキュリティベンダー、コミュニティプロジェクト、内部テレメトリーから提供される配信リストへの依存を強めている。
用途、例と重要性
ブラックリストは、不要なトラフィックを減らし、ポリシーを施行するために広く使われている。たとえば、境界ファイアウォールで既知の悪意あるホストを遮断する、電子メールゲートウェイでフィッシングドメインを防止する、管理対象デバイスで禁止されたアプリケーションのインストールを拒否する、といった用途がある。たとえばウェブプロキシでは、要求されたアドレスを確認し、拒否リストに含まれていれば拒否する。代表的なプロキシの役割については、ウェブプロキシの例を参照。
利点、限界と関連する手法
利点には、単純で遮断ルールの結果が予測しやすいことがある。一方で、ブラックリストは継続的な更新を必要とし、誤検知を生じる可能性があり、新種またはポリモーフィックな脅威への対応は難しいという重要な限界がある。攻撃者は、ドメイン、IPアドレス、ファイル署名を変更することでリストを回避する場合がある。こうした欠点のため、多くの組織は、より堅牢な保護を実現するために、ブラックリストをホワイトリスト、ヒューリスティック、振る舞いベースの検知、ゼロトラストの原則と組み合わせている。
主な相違点:ブラックリストは掲載された項目を拒否し、ホワイトリストは掲載された項目だけを許可する。どちらを選ぶかは、リスク許容度、規模、管理上の負担によって決まる。適切なガバナンス、見直し手順、異議申立ての経路は、運用上の誤りや意図しないサービス中断の低減に役立つ。
関連項目
著者
AlegsaOnline.com ブラックリスト(コンピューティング):概念、実装、トレードオフ Leandro Alegsa
URL: https://ja.alegsaonline.com/art/12012