バーチャル国際典拠ファイル(VIAF)|国際的な典拠レコード連携サービス
国立図書館などの典拠レコードを集約・クラスタリングし、個人名・団体名・著作名の共有識別子と相互リンクを提供する協力型サービス。
概要
バーチャル国際典拠ファイル(VIAF)は、国立図書館および大規模な書誌組織が作成した名称典拠レコードを集約し、照合する協力型サービスである。主な目的は、異なる名称形や出典レコードを、一般にVIAF IDと呼ばれる単一の機械可読識別子に結び付けることで、重複と混乱を減らすことにある。
画像ギャラリー
1 画像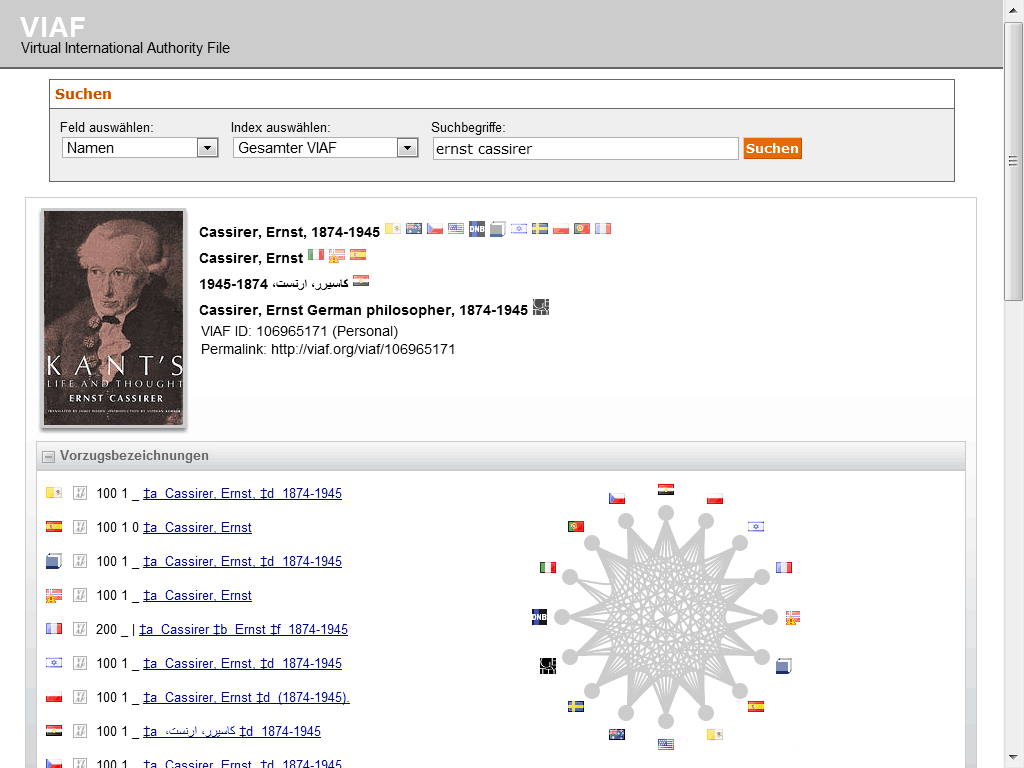
レコードの構造と内容
VIAFは各国の典拠ファイルを置き換えるものではなく、それらをクラスタリングするものである。典型的なVIAFクラスタは、同一の個人、団体、または著作を表す複数の出典レコードをまとめる。VIAFレコードに一般的に含まれる要素は、次のとおりである。
- 異なる言語・文字による優先名称形および別形
- 年月日、役割、簡潔な限定情報
- 提供元となる典拠レコードへのリンク
- 他のシステムとの統合を可能にする機械可読識別子
沿革と発展
複数の国立図書館と書誌組織の協力から生まれたVIAFは、目録間で長年にわたり存在してきた名称の曖昧さという問題に対処するために開発された。より多くの機関が典拠データを提供するにつれてプロジェクトは拡大し、その基盤も、図書館システムおよび研究者向けの一括ダウンロードとプログラムによるアクセスを支援するよう発展した。
用途と重要性
VIAFは、目録作成者、図書館、出版社、デジタル人文学プロジェクトにより、名称の曖昧性解消、システム間のレコード連携、発見支援のために利用されている。たとえば、図書館目録における著者名の統一、検索結果の改善、セマンティック・ウェブにおける書誌メタデータと外部データセットとの接続を可能にする用途がある。
特徴と限界
単一の国の典拠ファイルとは異なり、VIAFは各提供元へのリンクを保持する国際的な集約サービスである。文化遺産および研究で用いられる他の識別子システムを補完する。一方、参加する情報源を反映した収録範囲の不均一さ、異なる実体が誤って統合される可能性のあるクラスタリング誤り、提供機関からの更新への依存といった限界もある。
実用的なアクセス
VIAFは、人が読めるレコード表示と機械向けインターフェースの両方を提供しており、組織はVIAF識別子を目録、書誌、リンクトデータのアプリケーションに組み込むことができる。その識別子は、言語、文字、情報システムをまたいで名称を相互運用可能にするのに役立つ。
関連項目
著者
AlegsaOnline.com バーチャル国際典拠ファイル(VIAF)|国際的な典拠レコード連携サービス Leandro Alegsa
URL: https://ja.alegsaonline.com/art/105575